Kisah Klasik Saat Rilis Bot: Dipuji Waktu Demo, Diprotes Waktu Produksi
Pernah nggak kamu ngalamin momen ini?
Kamu baru saja selesai membangun bot RAG (Retrieval-Augmented Generation) untuk kebutuhan internal kantor. Pas sesi demo di depan tim atau manajemen, semua berjalan mulus tanpa cela. Kamu mengetik pertanyaan resmi yang rapi: "Bagaimana tata cara klaim penggantian biaya pengobatan rawat jalan bagi keluarga karyawan?"
Dalam hitungan detik, bot menarik dokumen SOP HR yang tepat, dan LLM menyusun jawaban yang sangat cerdas. Semua orang bertepuk tangan dan puas.
Tapi mimpi buruk baru dimulai pas sistem itu masuk tahap *pilot* atau dipakai karyawan betulan di Slack, Teams, atau WhatsApp helpdesk.
Mendadak bot kamu diprotes karena jawabannya sering ngaco atau bolak-balik bilang "Maaf, saya tidak menemukan dokumen yang relevan". Pas kamu intip log interaksinya, ternyata pengguna di dunia nyata nggak ada yang mengetik kalimat formal ala buku pelajaran. Yang masuk ke sistem malah kalimat acak seperti ini:
- "min tlg bgt paylaterku knp tb2 gbs dpke buat checkout pdhl limit msh byk?" (slang chat panik)
- "cra mngganti pasword email kntor yg kblokir gr2 slah pin" (typo parah / saltik jempol)
- "Status WO maintenance genset di modul CMMS masih open belum diapprove SPV" (singkatan teknis pabrik)
Di titik ini, banyak engineer langsung menyalahkan LLM generator-nya. Padahal biang kerok aslinya ada di gerbang paling awal: model embedding yang kamu pasang gagal memetakan bahasa harian orang Indonesia ke dokumen SOP resmi. Dokumen yang ditarik meleset jauh, sehingga LLM di belakangnya cuma dapat konteks sampah.
Berangkat dari masalah lapangan itu, artikel ini menguji langsung 6 model embedding open-source terpopuler di lingkungan on-premise lokal untuk melihat siapa yang paling tahan banting menghadapi 12 skenario teks nyata Indonesia. Mari kita bedah hasilnya satu per satu.
1. Jebakan Manis Leaderboard Global (MTEB)
Waktu kita merancang sistem RAG atau pencarian dokumen internal di kantor, dorongan untuk beralih ke model lokal on-premise sangat kuat. Tiga alasan utamanya sangat nyata: data sensitif perusahaan tidak boleh keluar ke cloud pihak ketiga, kepatuhan audit data internal terjaga, dan kita terbebas dari tagihan token API per bulan yang membengkak seiring naiknya trafik pencarian.
Namun, banyak developer tergoda jalan pintas: hanya melihat peringkat teratas di MTEB (Massive Text Embedding Benchmark) lalu langsung mengunduh model tersebut untuk dipakai di kantor.
Masalahnya, korpus evaluasi MTEB didominasi artikel berbahasa Inggris yang sangat terstruktur, bersih, dan berstandar akademik. Begitu model tersebut dihadapkan pada cara mengetik pengguna Indonesia yang penuh kontraksi kata, singkatan percakapan, istilah bahasa campuran (code-switching), dan akronim sistem kerja (ERP/CMMS), representasi vektornya langsung berantakan.
Tanpa evaluasi pada dataset yang mencerminkan realitas lokal, kita bagaikan membeli mobil balap jalan raya untuk dipakai di jalanan off-road berlumpur.
2. Model yang Diuji dan 12 Skenario Nyata
Biar pengujian ini transparan dan bisa kamu replikasi, ada 6 model embedding open-source yang kita adu:
- EmbeddingGemma-2 (Versi Baru): Generasi kedua dari Google. Karena paket Ollama lokal saat pengujian belum menyediakan update versi 2 ini, model ditarik langsung dari Hugging Face dan disajikan via dedicated FastAPI.
- EmbeddingGemma (Versi Awal / v1): Model generasi pertama dari Google yang sudah tersedia di ekosistem Ollama lokal.
- Nomic-Standard (nomic-embed-text): Model embedding teks standar yang populer dan ringan di Ollama.
- Nomic-MoE-v2: Varian arsitektur Mixture of Experts (MoE) dari Nomic di Ollama.
- BGE-M3: Model embedding multibahasa yang sangat populer dari BAAI di Ollama.
- Qwen3-Embedding: Model embedding open-source dari keluarga Qwen di Ollama.
12 Skenario Pengujian Lapangan
Tiap pengujian memasangkan satu query riil pengguna dengan satu dokumen target SOP perusahaan yang seharusnya berhasil ditarik. Kualitas kecocokan diukur lewat nilai cosine similarity (rentang 0 sampai 1).
| No | Kategori | Input Query Pengguna | Target Dokumen SOP |
|---|---|---|---|
| 1 | Slang Chat / Livechat | "min tlg bgt paylaterku knp tb2 gbs dpke buat checkout pdhl limit msh byk?" | Penyebab pembekuan limit kredit paylater dan kendala transaksi checkout akun pengguna. |
| 2 | Typo Parah (Fat Finger) | "cra mngganti pasword email kntor yg kblokir gr2 slah pin" | Panduan pemulihan kata sandi surel perusahaan dan pembukaan blokir keamanan akun. |
| 3 | Akronim ERP & CMMS | "Status WO maintenance genset di modul CMMS masih open belum diapprove SPV" | Alur otorisasi work order perawatan generator listrik pada sistem manajemen pemeliharaan fasilitas. |
| 4 | Code-Switching (Indo-EN) | "Gimana cara request approval deployment service ke production environment?" | Prosedur pengajuan izin rilis aplikasi ke server produksi dan verifikasi sistem operasional. |
| 5 | Cross-Lingual (EN to ID) | "How to submit medical outpatient reimbursement for employee dependents?" | Tata cara klaim penggantian biaya pengobatan rawat jalan bagi tanggungan keluarga karyawan. |
| 6 | Gejala Fisik ke Solusi | "Mesin fotokopi kantor keluar asap tipis, bau hangus, dan kertas nyangkut terus" | Penanganan paper jam dan troubleshooting panas berlebih pada unit mesin multifungsi printer. |
| 7 | Zero Lexical Overlap | "Kapan upah bulanan ditransfer ke rekening pegawai?" | Jadwal pencairan gaji rutin dan penyaluran slip pendapatan bagi seluruh staf pekerja. |
| 8 | Pencarian Telegrafis / Keyword | "cuti melahirkan syarat durasi potong gaji atau tidak" | Kebijakan hak maternitas: jangka waktu istirahat melahirkan serta ketentuan penerimaan upah penuh. |
| 9 | Pertanyaan Naratif Panjang | "Kemarin sore lampu dan stopkontak di ruang rapat lantai 3 sayap barat mati total waktu dipakai presentasi, tolong tim GA cek sekringnya" | Laporan gangguan kelistrikan gedung kantor dan perbaikan panel distribusi MCB oleh divisi General Affairs. |
| 10 | Keamanan & Alert Fraud | "Ada notifikasi transaksi mencurigakan dari kartu debit saya padahal lagi tidur" | Prosedur pelaporan aktivitas fraud perbankan digital dan pemblokiran darurat rekening nasabah. |
| 11 | Plafon & Regulasi Finansial | "Berapa plafon kacamata dan batas maksimal reimburse perawatan gigi per tahun?" | Rincian batas maksimal tunjangan optik dan reimbursement perawatan dental pada asuransi kesehatan karyawan. |
| 12 | Intent Pembatalan / Negasi | "Saya tidak mau memperpanjang kontrak sewa perangkat dan ingin berhenti berlangganan" | Ketentuan terminasi perjanjian sewa aset serta prosedur penghentian tagihan bulanan pelanggan. |
3. Leaderboard Akurasi Semantik: Siapa yang Unggul?
Ini dia rekapitulasi rata-rata skor kemiripan dari 12 skenario pengujian. Semakin mendekati angka 1, berarti model makin presisi memahami hubungan antara maksud query pengguna dan isi dokumen target.
| Peringkat | Model Embedding | Serving Method | Rata-rata Skor |
|---|---|---|---|
| Juara 1 | EmbeddingGemma-2 (Versi Baru) | Dedicated FastAPI Server | 0.7457 |
| Peringkat 2 | Nomic-Standard (nomic-embed-text) | Ollama Local | 0.6140 |
| Peringkat 3 | BGE-M3 | Ollama Local | 0.6103 |
| Peringkat 4 | Qwen3-Embedding | Ollama Local | 0.6015 |
| Peringkat 5 | EmbeddingGemma (Versi Awal / v1) | Ollama Local | 0.5465 |
| Peringkat 6 | Nomic-MoE-v2 | Ollama Local | 0.4535 |
Posisi puncak dipegang telak oleh EmbeddingGemma-2 dengan rata-rata skor 0.7457. Di posisi berikutnya, Nomic-Standard dan BGE-M3 bersaing ketat di angka 0.61. Sementara EmbeddingGemma generasi awal (v1) berada di peringkat lima dengan skor 0.5465.
4. Peta Panas Kemiripan Semantik (Heatmap)
Supaya kamu bisa lihat pola ketahanan tiap model di tiap kategori secara gamblang, ini visualisasi heatmap lengkapnya:
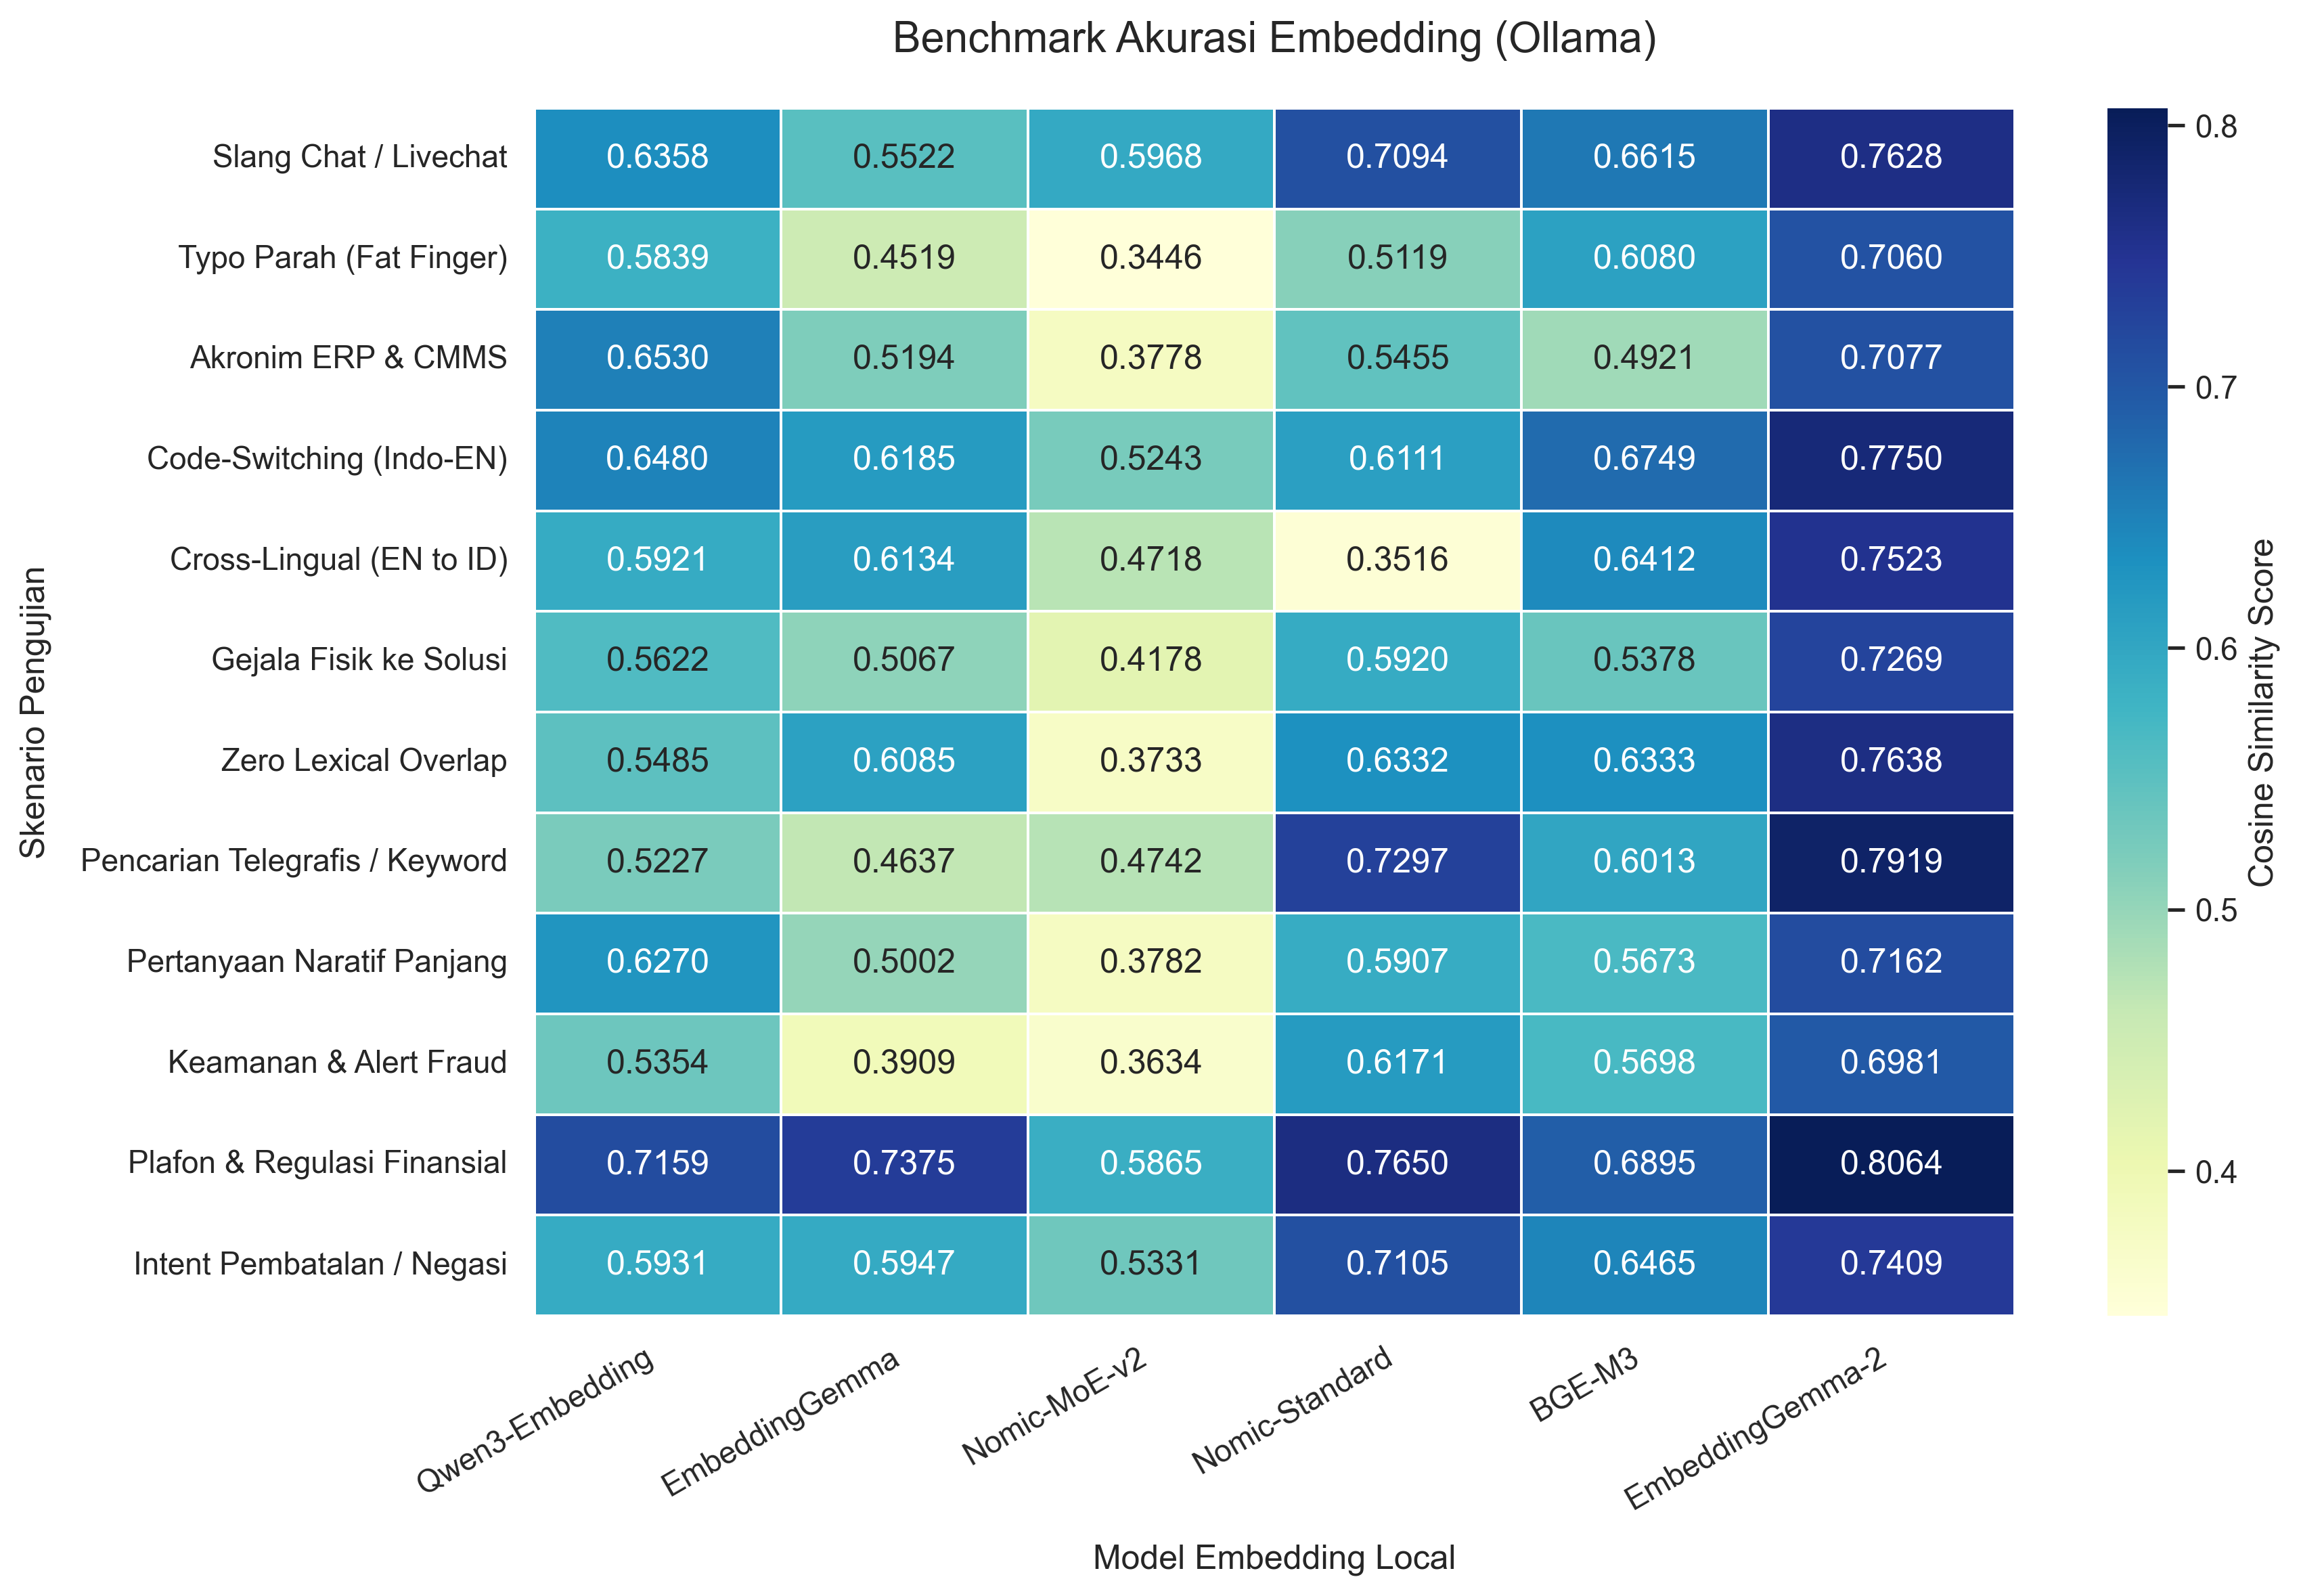
Visualisasi Matriks Cosine Similarity Model Embedding Lokal pada 12 Skenario Bahasa Indonesia.
5. Matriks Skor Lengkap per Skenario
Tabel berikut memuat angka detail untuk masing-masing model di setiap kasus uj:
| Kategori Skenario | Qwen3 | Gemma (v1) | Nomic MoE | Nomic Std | BGE-M3 | Gemma-2 (v2) |
|---|---|---|---|---|---|---|
| Slang Chat / Livechat | 0.6358 | 0.5522 | 0.5968 | 0.7094 | 0.6615 | 0.7628 |
| Typo Parah (Fat Finger) | 0.5839 | 0.4519 | 0.3446 | 0.5119 | 0.6080 | 0.7060 |
| Akronim ERP & CMMS | 0.6530 | 0.5194 | 0.3778 | 0.5455 | 0.4921 | 0.7077 |
| Code-Switching (Indo-EN) | 0.6480 | 0.6185 | 0.5243 | 0.6111 | 0.6749 | 0.7750 |
| Cross-Lingual (EN to ID) | 0.5921 | 0.6134 | 0.4718 | 0.3516 | 0.6412 | 0.7523 |
| Gejala Fisik ke Solusi | 0.5622 | 0.5067 | 0.4178 | 0.5920 | 0.5378 | 0.7269 |
| Zero Lexical Overlap | 0.5485 | 0.6085 | 0.3733 | 0.6332 | 0.6333 | 0.7638 |
| Pencarian Telegrafis / Keyword | 0.5227 | 0.4637 | 0.4742 | 0.7297 | 0.6013 | 0.7919 |
| Pertanyaan Naratif Panjang | 0.6270 | 0.5002 | 0.3782 | 0.5907 | 0.5673 | 0.7162 |
| Keamanan & Alert Fraud | 0.5354 | 0.3909 | 0.3634 | 0.6171 | 0.5698 | 0.6981 |
| Plafon & Regulasi Finansial | 0.7159 | 0.7375 | 0.5865 | 0.7650 | 0.6895 | 0.8064 |
| Intent Pembatalan / Negasi | 0.5931 | 0.5947 | 0.5331 | 0.7105 | 0.6465 | 0.7409 |
6. Bedah Kasus: Dari Slang, Typo Jempol, sampai Zero Lexical Overlap
Melihat tabel matriks di atas, ada beberapa insight berharga yang wajib kamu perhatikan waktu nyiapin vector search untuk data internal berbahasa Indonesia:
A. Slang Chat vs Typo Parah: Ujian Tokenizer
Di skenario Slang Chat ("min tlg bgt paylaterku knp tb2 gbs dpke buat checkout..."), tiga model berhasil lolos di atas skor 0.65: EmbeddingGemma-2 (0.7628), Nomic-Standard (0.7094), dan BGE-M3 (0.6615).
Tapi pas diuji dengan Typo Jempol ("cra mngganti pasword email kntor..."), kelihatan mana model yang tokenizer-nya beneran lentur. EmbeddingGemma-2 tetap kokoh di 0.7060 dan BGE-M3 di 0.6080. Sebaliknya, Nomic-Standard turun ke 0.5119, dan Nomic-MoE malah ambruk ke 0.3446. Artinya, kalau use-case kamu banyak nerima ketikan cepat dari mobile apps atau WhatsApp bot, EmbeddingGemma-2 dan BGE-M3 jauh lebih aman.
B. Ujian Terberat: Zero Lexical Overlap
Ini skenario yang paling bikin puas dan jadi alasan utama kenapa kita pakai vector embedding alih-alih cuma mengandalkan pencarian kata kunci biasa (BM25 atau Elasticsearch):
Query Pengguna: "Kapan upah bulanan ditransfer ke rekening pegawai?"
Dokumen Target: "Jadwal pencairan gaji rutin dan penyaluran slip pendapatan bagi seluruh staf pekerja."
Coba perhatikan baik-baik: nggak ada satu pun kata yang sama antara kalimat pertanyaan dan isi dokumen target.
- Upah berpadanan dengan gaji.
- Pegawai berpadanan dengan staf pekerja.
- Ditransfer berpadanan dengan pencairan rutin.
Kalau kamu cuma pakai BM25 biasa, skor pencariannya bakal nol besar karena tidak ada kata yang cocok. Tapi di pengujian embedding kita, EmbeddingGemma-2 mencetak skor 0.7638, sementara Nomic-Standard dan BGE-M3 sama-sama dapat skor 0.633. Ini bukti nyata kalau model embedding memang paham konteks makna, bukan cuma mencocokkan huruf.
C. Akronim Pabrik dan Sistem ERP/CMMS
Query kayak "Status WO maintenance genset di modul CMMS masih open belum diapprove SPV" itu makanan sehari-hari tim operasional (WO = Work Order, CMMS = Computerized Maintenance Management System, SPV = Supervisor).
Di kasus ini, EmbeddingGemma-2 (0.7077) dan Qwen3-Embedding (0.6530) berhasil mengaitkan istilah singkatan tersebut ke SOP pemeliharaan fasilitas umum kantor. Sayangnya, BGE-M3 (0.4921) dan Nomic-MoE (0.3778) terlihat kesulitan mengenali pola akronim kerja seperti ini.
7. Analisis Menarik: Lompatan Generasi Gemma & Nasib Arsitektur MoE
Ada dua temuan teknis yang sangat penting buat catatan arsitektur kamu:
1. Lompatan Drastis Generasi: EmbeddingGemma v1 vs EmbeddingGemma-2
Salah satu temuan paling mencolok dari eksperimen ini adalah perbedaan skor antara dua generasi model EmbeddingGemma:
- EmbeddingGemma versi awal (v1): 0.5465
- EmbeddingGemma-2 (versi baru): 0.7457
Kenaikan hampir 0.20 poin ini murni buah dari evolusi arsitektur model baru Google. Di versi 2 (EmbeddingGemma-2), Google melakukan lompatan besar dalam kalibrasi representasi semantik dan pemahaman multibahasa, termasuk ketahanannya membaca teks acak bahasa Indonesia.
Catatan praktis di lapangan: Kenapa versi 2 kami jalankan lewat FastAPI dari Hugging Face sementara versi 1 di Ollama? Murni karena paket Ollama lokal saat pengujian belum menyediakan update rilis untuk versi 2 ini. Jadi kalau kamu mau akurasi juara saat ini juga, jangan terjebak cuma pakai v1 yang ada di Ollama: tarik bobot resmi EmbeddingGemma-2 langsung dari Hugging Face dan jalankan via dedicated container atau FastAPI.
2. Nomic-Standard Menang Telak Lawan Nomic-MoE-v2
Secara teori, arsitektur Mixture of Experts (MoE) sering digembar-gemborkan lebih pintar karena punya kapasitas parameter lebih besar. Tapi data pengujian berbicara lain: varian Nomic-Standard (0.6140) justru unggul jauh di atas Nomic-MoE-v2 (0.4535).
Varian MoE tampaknya belum terkalibrasi dengan baik untuk sebaran teks informal bahasa Indonesia. Jadi, jangan langsung berasumsi kalau model versi baru atau berlabel "MoE" pasti otomatis lebih bagus untuk bahasa lokal kita.
8. Contekan Praktis Buat Pipeline RAG Kamu
Biar hasil benchmark ini langsung bisa kamu eksekusi di kerjaan sehari-hari, ini rangkuman rekomendasi arsitekturnya:
Rekomendasi Pemilihan Model
- Pilihan Utama untuk Akurasi Tertinggi: Gunakan EmbeddingGemma-2 (versi baru). Model ini terbukti paling konsisten membaca slang, typo, dan istilah teknis kita. Karena Ollama belum tentu update ke v2, ambil bobot resminya langsung dari Hugging Face dan deploy via FastAPI atau Text Embeddings Inference (TEI).
- Pilihan Praktis di Ekosistem Ollama: Kalau kamu butuh setup instan lewat model yang sudah ready di Ollama tanpa setup server terpisah, Nomic-Standard dan BGE-M3 adalah dua opsi paling solid. Jangan pakai EmbeddingGemma v1 karena skornya tertinggal jauh.
- Hindari Dulu: Tahan diri buat pakai varian Nomic-MoE untuk teks bahasa Indonesia sampai ada rilis bobot atau fine-tuning yang lebih matang.
Gunakan Pola Hybrid Search (BM25 + Dense Retrieval)
Biarpun model embedding sangat jago nangkep maksud abstrak, pencarian vektor murni kadang masih punya titik lemah: nomor part mesin, serial number perangkat, atau kode tiket yang butuh kecocokan karakter 100% persis.
Arsitektur paling aman dan teruji di industri adalah Hybrid Search:
- Dense Retrieval (Vektor): Pakai model embedding lokal (misal EmbeddingGemma-2) buat nangkep maksud umum, slang, dan kalimat panjang. Ambil Top-25 dokumen.
- Sparse Retrieval (BM25): Pakai BM25 buat nangkep exact match kode error, nomor invoice, atau nama vendor. Ambil Top-25 dokumen.
- Reciprocal Rank Fusion (RRF): Gabungkan kedua hasil pencarian tadi sebelum dikirim ke LLM generator. Dengan cara ini, bot kamu dapat yang terbaik dari dua dunia: paham makna dan nggak meleset di kata kunci presisi.
Penutup
Model embedding lokal open-source sekarang sudah sangat matang buat nanganin bahasa Indonesia sehari-hari, asalkan kita tepat memilih versi modelnya. Menggunakan EmbeddingGemma-2 di hardware server sendiri ngasih kita kendali penuh: data aman di internal, biaya terkendali, dan akurasi retrieval tetap jempolan.
Yuk, langsung coba uji korpus data kantor kamu sendiri di mesin lokal!
*Catatan Pengujian: Seluruh data benchmark pada pengujian lokal ini dijalankan menggunakan GPU NVIDIA GeForce RTX 5070 Ti.
Comments